El problema: RoCE no fue diseñado para un millón de GPUs
Si alguna vez has sufrido con un job de entrenamiento distribuido que se atora porque un solo link lento frenó todo el all-reduce, sabes de lo que hablamos. Las operaciones colectivas sincronizan miles de aceleradores, y la transferencia más lenta marca el ritmo del job completo.
El RoCEv2 estándar fue pensado para un mundo donde la fabric garantiza cero pérdidas vía PFC y entrega los frames en orden. Funciona bien a escala chica. A la escala de Meta — cientos de miles de GPUs repartidas entre data centers y regiones — eso se vuelve un pasivo:
- PFC genera head-of-line blocking y tormentas de pause
- La entrega en orden desincentiva el packet spraying, que es justo lo que necesitas en fabrics multiplane
- Cada queue pair (QP) carga su propia ventana de congestión, ciega a las demás
La idea central de MetaRoCE es engañosamente simple: la fabric ve paquetes, pero la NIC ve intención. Así que Meta movió la inteligencia al endpoint.
Si te gusta entender cómo la gobernanza abierta transforma ecosistemas completos, checa nuestro post sobre la migración de React Foundation a la Linux Foundation — la misma filosofía multi-vendor aplica aquí.
Cómo funciona MetaRoCE de verdad
Cuatro pilares sostienen todo el protocolo:
1. Entrega fuera de orden nativa
MetaRoCE hace spray de paquetes por muchos caminos, así que llegan fuera de orden a propósito. Cada paquete carga su propio destino, entonces el dato se escribe directo en la memoria final al llegar — sin reorder buffer, sin head-of-line blocking.
# Vista conceptual: cómo un Send llega sin esperar predecesores
# (Pseudocódigo ilustrando el matching endpoint-driven de MetaRoCE)

def handle_incoming_packet(pkt):
    # Cada paquete carga su destino — sin reorder buffer
    if pkt.type == "WRITE":
        write_to_memory(pkt.dest_addr, pkt.payload)
    elif pkt.type == "SEND":
        # Hace match directo contra el buffer de recepción posteado
        # Aunque los mensajes anteriores no hayan llegado todavía
        match_and_deliver(pkt.match_bits, pkt.payload)
    # ACK inmediato — sin round trip para aprender el destino
    send_ack(pkt.seq, pkt.path_id)
2. Multipathing nativo
Cada conexión obtiene caminos de primera clase, con ventanas y estimaciones de RTT por camino. Un puerto UDP de origen distinto por camino sirve como entropía ECMP, y la NIC puede cambiarlo en vivo para esquivar un link malo. En fabrics multiplane, la selección de plano queda 100% en la NIC — la fabric solo reenvía.
3. Tolerancia a pérdidas por diseño
Sin PFC. Sin pause frames. MetaRoCE trata Ethernet como red con pérdidas y no le pide otra cosa. Cada camino carga su propia secuencia ordenada, entonces un hueco en su bitvector SACK de 256 bits es evidencia de pérdida, no de reordenamiento. El SACK dispara retransmisión exacta del paquete faltante, en el camino que lo perdió, en el momento en que aparece el hueco.
4. Control de congestión desde ambos lados
MetaRoCE combina AIMD basado en ECN (sender-driven) con pistas de fair-share desde el receptor. En cada ACK, el receptor devuelve la porción de ancho de banda que asignó a ese sender — así los senders llegan directo a la velocidad correcta en vez de buscarla. Incast se resuelve en uno o dos round trips.
Benchmarks (clúster AMD de 64 nodos, colectivas RCCL)
| Métrica | RoCEv2 | MetaRoCE |
|---|---|---|
| Throughput @ 0% pérdida | Baseline | Mayor |
| Throughput @ 1% pérdida | Degradado | ~86% |
| Throughput @ 10% pérdida | Colapso | Aún útil |
| Escalado multiplane | Limitado | Lineal (4/8 planos verificados) |
| Recuperación de falla de plano | Manual | Autónoma |
Si quieres prototipar los conceptos antes de tocar hardware real, nuestro guía de CodePen slideVars muestra cómo armar visualizaciones interactivas de cambios de estado — ideal para demostrar lógica de flujo de paquetes.
Qué cambia esto para tu clúster
Independencia de topología
MetaRoCE le pide a la fabric exactamente dos cosas que todo switch ya tiene: marcado ECN y ECMP. No requiere packet trimming, telemetría in-network, control de flujo basado en créditos, ni spraying del lado del switch. El mismo transporte corre sobre fat-tree, multiplane, deep-buffer y shallow-buffer — incluyendo clouds de vendors cuya config no controlas.
Conexiones unificadas a escala
RDMA tradicional gana ancho de banda abriendo más QPs — docenas por par de nodos, cada una con su propia ventana de congestión. MetaRoCE separa streams de ancho de banda: una sola conexión carga muchos streams ordenados independientes arriba y muchos caminos abajo, bajo un solo controlador de congestión. El estado de la conexión deja de crecer con el paralelismo del workload.
Lo que sigue igual
Las APIs RDMA Verbs existentes y los stacks de software funcionan sin modificación. Features extra como soporte multiplane llegan vía APIs de extensión. Eso es enorme para quien tiene inversión grande en código RDMA existente.
Limitaciones honestas
- Scale-up todavía no está resuelto. Dentro del rack, MetaRoCE elimina el reorder buffer y el PFC, pero el camino rápido de señalización para operaciones cortas de memoria (PE-to-PE) sigue optimizándose.
- Scale-across está en progreso. Links largos con RTT en milisegundos y pequeñas asimetrías de camino son otro régimen — compartir justamente links largos congestionados es trabajo activo.
- Storage/KV-cache es una dimensión nueva. Mantener las pistas de rate del receptor precisas con velocidades de red y tamaños de request variables sigue abierto.
- Dependencia del ecosistema. El éxito depende de que los vendors de NIC realmente entreguen silicio compatible. La spec es abierta, pero el silicio toma tiempo.
Conclusión
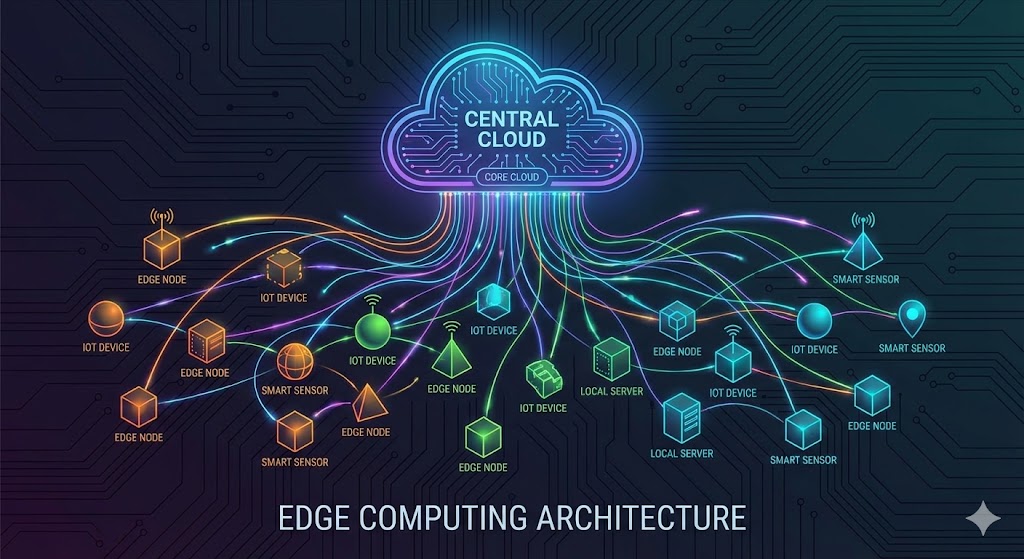
MetaRoCE es una apuesta a que diseñar para pérdidas desde el día cero le gana a fingir que Ethernet es InfiniBand. Al empujar la inteligencia al endpoint y tratar los caminos como entidades de primera clase, obtienes un transporte que rinde mejor en condiciones ideales y degrada con gracia cuando las cosas salen mal — 86% de throughput con 1% de pérdida no es un typo.
La especificación, una implementación de referencia optimizada para DPDK y un framework de compliance de producción se están liberando vía OCP. Si construyes NICs, switches o infra de IA, vale la pena seguirlo de cerca.
Próximos pasos
- Lee la spec de OCP cuando salga y compárala con la semántica de flow control de RoCEv2.
- Experimenta con la implementación de referencia (
libsoftmetaroce) — corre en Linux común sobre sockets UDP estándar, sin hardware especial. - Estudia el compliance suite si estás evaluando vendors de NIC — es la herramienta que prueba si una implementación coincide con la spec.
- Sigue la iniciativa ESUN — MetaRoCE extiende su filosofía multi-vendor de la capa de fabric a la capa de transporte.
Lectura complementaria
- Gobernanza abierta de React Foundation — por qué los estándares abiertos multi-vendor siguen ganando
- Guía CodePen slideVars — arma demos interactivas para visualizar comportamiento de protocolo
Basado en el anuncio de MetaRoCE publicado en Meta Engineering.