왜 지금 '하이브리드 오케스트레이션'인가
수백 개 지역에 흩어진 데이터센터를 운영하는 팀이라면 한 번쯤 이런 상황을 겪어보셨을 거예요.
- A 사이트에서는 BIOS 펌웨어가 v1.2인데, B 사이트는 v1.0이라서 동일한 클러스터 배포가 실패
- 야간에 3개 사이트 서버 200대를 리부팅하려는데, 담당자가 각 사이트 VPN 들어가서 수작업
- "우리 전체 서버 중 펌웨어 구버전이 몇 대지?"라는 질문에 아무도 즉답을 못 함
이건 단순한 운영 이슈가 아니라 아키텍처 부재의 문제예요. AWS가 최근 공개한 이 하이브리드 클라우드 오케스트레이션 아키텍처는 바로 이 지점을 정면으로 공략합니다. 데이터 주권, 규제, DDIL(Disconnected, Disrupted, Intermittent, Limited) 네트워크 환경 때문에 컨트롤 플레인조차 온프레미스에 둬야 하는 상황을 전제로 설계됐어요.
핵심은 이겁니다. "컨트롤 플레인은 AWS에, 실행은 온프레미스에." 그런데 여기서 자연스럽게 드는 의문이 있죠. 네트워크가 끊겨도 동작해야 하는데 어떻게 AWS가 온프레미스를 제어하지? 이 질문에 대한 답이 이 아키텍처의 진짜 재미있는 부분입니다.
참고로 이 글은 AWS Architecture Blog의 근거자료를 바탕으로, 실무자 관점에서 재해석한 분석입니다.
4개의 축으로 이해하는 핵심 기술 스택
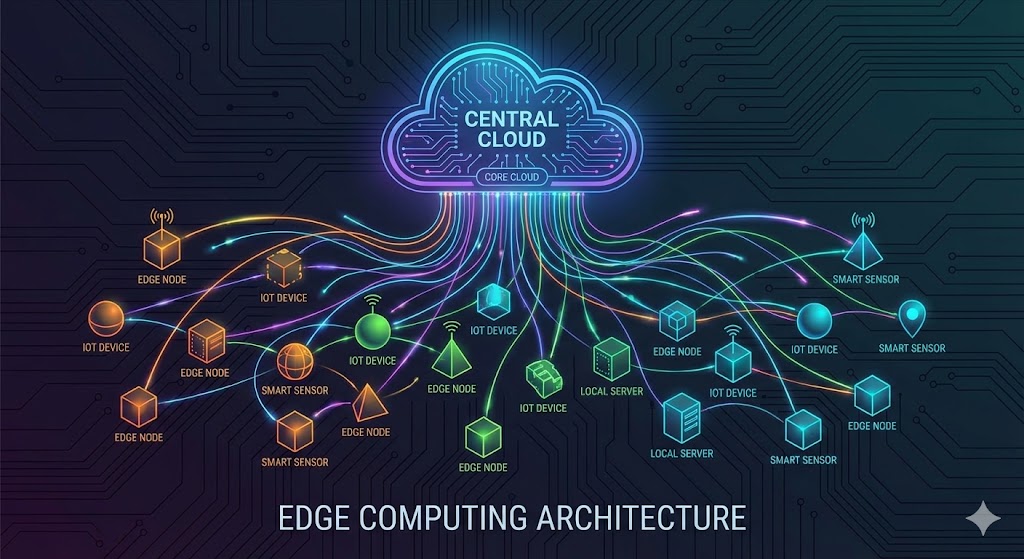
이 아키텍처는 크게 4개 기술이 맞물려 돌아갑니다. 각각 따로 보면 평범한데, 조합되는 순간이 진짜예요.
1. 하이브리드 커넥티비티 (AWS Direct Connect / Site-to-Site VPN)
AWS VPC 안의 서비스가 온프레미스 인프라와 라이프사이클 작업을 조율할 수 있는 기반이에요. Direct Connect는 전용 회선, Site-to-Site VPN은 인터넷 위의 암호화 터널이죠. DDIL 환경이라면 여기서부터 설계가 갈립니다.
2. AWS 서버리스 오케스트레이션 스택
- AWS Lambda: API 요청 검증, 파라미터 처리
- AWS Step Functions: 상태 머신 기반 워크플로 실행
- Amazon EventBridge: 이벤트 라우팅 및 반응형 자동화
- Amazon DynamoDB: 인벤토리 상태 저장소
- AWS Systems Manager / Batch / CodeBuild: 온프레미스 실행 런타임
여기서 가장 중요한 개념이 Step Functions의 콜백 패턴(Callback Pattern) 입니다.
{
  "Comment": "온프레미스 펌웨어 업데이트를 위한 콜백 패턴 예시",
  "StartAt": "RequestFirmwareUpdate",
  "States": {
    "RequestFirmwareUpdate": {
      "Type": "task",
      "Resource": "arn:aws:states:::lambda:invoke.waitForTaskToken",
      "Parameters": {
        "FunctionName": "TriggerRedfishFirmwareUpdate",
        "Payload": {
          "serverId.quot;: "$.serverId",
          "taskToken.quot;: "$.Task.Token"
        }
      },
      "TimeoutSeconds": 86400,
      "Next": "VerifyFirmwareVersion"
    },
    "VerifyFirmwareVersion": {
      "Type": "task",
      "Resource": "arn:aws:lambda:VerifyFirmware",
      "End": true
    }
  }
}
포인트는 waitForTaskToken이에요. 워크플로가 최대 24시간까지 멈춰서 기다릴 수 있다는 뜻입니다. 펌웨어 업데이트나 클러스터 배포처럼 몇 시간 걸리는 작업을 폴링 없이 처리할 수 있죠. 이게 없으면 매 5분마다 상태 체크하는 폴링 지옥이 열립니다.
3. Redfish API — 벤더 중립 하드웨어 제어
DMTF가 만든 표준 프로토콜로, Dell이든 HPE든 Supermicro든 동일한 API로 BIOS 설정, 펌웨어 업데이트, 전원 관리, 헬스 체크를 수행할 수 있어요. 벤더별 SDK를 각각 관리할 필요가 없어지는 순간입니다.
4. Amazon EKS Anywhere
Amazon EKS Distro를 온프레미스에서 그대로 돌리는 방식이에요. 관리 클러스터(Management)와 워크로드 클러스터(Workload)로 나뉘고, 이 관계가 인벤토리 시스템에 기록돼서 전체 클러스터 분포를 한눈에 볼 수 있게 됩니다.
AWS 리전과 안정적으로 연결되는 엣지 환경이라면 EKS Hybrid Nodes가 더 권장된다는 점은 기억해두세요. EKS Anywhere는 컨트롤 플레인 자체가 온프레미스에 있어야 하는 규제/주권 사유일 때 선택하는 카드입니다.
실무에서 반드시 짚어야 할 3가지 함정
함정 1: "이벤트 기반"이라고 다 좋은 게 아니다
EventBridge + Step Functions 조합은 강력하지만, 이벤트 순서 보장이 안 됩니다. 예를 들어 "클러스터 업그레이드 시작" 이벤트와 "클러스터 스케일링 요청" 이벤트가 동시에 들어오면? 이 아키텍처는 인벤토리 시스템과의 연동으로 충돌 관리(Conflict Management) 를 수행합니다. 동일 리소스에 대해 이미 실행 중인 주문(Order)이 있으면 신규 주문을 거부하는 방식이죠.
실무 팁: 주문 상태를 DynamoDB에 기록할 때 조건부 쓰기(Conditional Write) 를 반드시 걸어두세요. attribute_not_exists(orderId) 같은 조건이 없으면 동시성 이슈로 중복 실행됩니다.
함정 2: 콜백 패턴의 타임아웃과 보안
waitForTaskToken은 최대 1년까지 대기 가능하지만, 실무에서는 작업 특성에 맞는 타임아웃을 명시해야 해요. 펌웨어 업데이트는 24시간, 클러스터 생성은 2시간, 전원 리부팅은 30분 — 이런 식으로요. 타임아웃이 없으면 좀비 워크플로가 쌓입니다.
그리고 Task Token은 절대 로그에 남기지 마세요. 이 토큰 하나로 워크플로를 재개시킬 수 있어서, 유출되면 악의적인 상태 전이가 가능합니다. Secrets Manager나 Parameter Store(SecureString)에 저장하고, 온프레미스 쪽에는 짧은 수명의 자격증명만 내려보내세요. IAM Roles Anywhere가 바로 이 역할입니다.
함정 3: 한국 SI/금융권 환경에서의 현실
국내 금융권이나 공공 SI 환경에서는 망분리 요건 때문에 이 아키텍처를 그대로 적용하기 어려운 케이스가 많아요. AWS VPC와 온프레미스 사이 연결이 망분리 정책상 제한되면, Direct Connect나 VPN 자체가 심의 대상이 됩니다.
이럴 때는 두 가지 우회 전략이 있습니다.
- 오케스트레이션 엔진만 온프레미스에 배포: Step Functions 대신 오픈소스 워크플로 엔진(Temporal, Argo Workflows)으로 대체하고, AWS는 관측성/스토리지 레이어로만 활용
- AWS Outposts 활용: 하드웨어 자체를 IDC에 두고 AWS 관리형 서비스로 제어 — 다만 비용이 상당합니다
또 하나, 국내 환경에서는 Redfish 지원 서버 비율이 생각보다 낮습니다. Dell iDRAC, HPE iLO는 최신 세대에서 잘 지원하지만, 5년 이상 된 서버는 Redfish 펌웨어가 없거나 버그가 많아요. 도입 전에 반드시 하드웨어 인벤토리 사전 조사를 하세요.
그래서, 지금 시작한다면?
이 아키텍처의 진짜 가치는 "AWS 서비스를 쓴다"가 아니라 "서버리스로 수백 개 사이트를 일관성 있게 관리한다" 는 패턴 그 자체에 있어요. AWS 없이도 이 패턴은 이식 가능합니다.
다음 단계 학습 방향
- Step Functions 콜백 패턴부터 익히기 — 이 아키텍처의 심장입니다.
.waitForTaskToken통합 패턴을 작은 워크플로로 직접 만들어보세요. - Redfish API 실습 — 서버 한 대에
curl로 Redfish 엔드포인트를 찔러보는 것부터 시작./redfish/v1/Systems응답을 보면 감이 옵니다. - EKS Anywhere Docker Provider로 로컬 테스트 — 베어메탈 없이도 Docker provider로 개발/테스트가 가능합니다. 본 아키텍처를 부분적으로 재현해볼 수 있어요.
- 인벤토리 설계 먼저 — DynamoDB 테이블 스키마를 그리는 단계에서 이미 아키텍처의 70%가 결정됩니다.
이 기술의 명확한 한계
- EKS Anywhere의 클러스터 라이프사이클은 전적으로 사용자 책임입니다. AWS 관리형 EKS와 달리 업그레이드, 보안 패치, etcd 백업을 직접 챙겨야 해요.
- 콜백 패턴은 온프레미스 에이전트의 신뢰성에 100% 의존합니다. 에이전트가 죽으면 워크플로도 멈춥니다. 헬스체크와 재시도 정책을 반드시 설계에 포함하세요.
- 비용은 '서버리스'라는 이름값을 합니다. 수백 사이트 × 수천 서버의 이벤트 볼륨에서는 Lambda 호출 비용과 DynamoDB WCU가 무시 못 할 수준이에요. 사전에 비용 모델링을 반드시 하세요.
함께 보면 좋은 글
- "UX 디자인에 감정의 흐름을 심는 법 — 애니메이션에서 배우는 제품 경험 설계" — 대규모 시스템을 설계할 때도 결국 사용자(운영자) 경험이 성패를 가릅니다.
- "데이터 레이크 전체를 온라인 서비스처럼? Spotify가 만든 RAP(Random Access Parquet) 기술 해부" — 대규모 분산 데이터를 다루는 관점에서 이 아키텍처의 인벤토리 설계와 연결되는 인사이트를 얻을 수 있어요.
수백 개 사이트를 관리하는 팀이라면, 이 아키텍처는 "언젠가 해야 할 일"이 아니라 "지금 패턴을 익혀둬야 할 일" 입니다. 서버리스든 온프레미스 워크플로 엔진이든, 핵심 패턴은 동일하니까요. 😊